
Se você atua na área de dados utilizando Python ou PySpark, provavelmente, em algum momento, já utilizou a biblioteca Pandas ou o dataframe nativo do PySpark. Os dataframes são muito úteis e nos permitem transformar dados enquanto os mantemos em memória em um formato tabular. Contudo, se você já teve a oportunidade de utilizar estas duas opções, sabe que são tecnologias completamente distintas, possuindo cada uma delas as suas vantagens e desvantagens. Neste artigo vamos explorar um pouco as características de cada uma destas tecnologias e analisar em que situação elas podem ser melhor aplicadas.
Vamos começar pelo dataframe PySpark, sendo uma abstração criada sobre os RDDs do Spark. O que eu quis dizer com tudo isso? Bem, o Spark é uma ferramenta que permite realizar processamento em paralelo ao distribuir os dados para um cluster dedicado de computadores. Quando os dados estão distribuídos pelo cluster eles utilizam de uma estrutura chamada RDD (Resilient Distributed Datasets) que é a estrutura base do Spark. É possível realizar o processamento diretamente em RDDs, porém estas são estruturas fortemente tipadas, com poucas funções built-in e muito complexas de serem manipuladas. Por isso, foi desenvolvido o dataframe nativo do PySpark, trazendo diversas funções built-in e maior flexibilidade para a transformação dos dados, possibilitando, inclusive, que os dados sejam manipulados por meio de comandos SQL aplicados diretamente nos dados do dataframe.
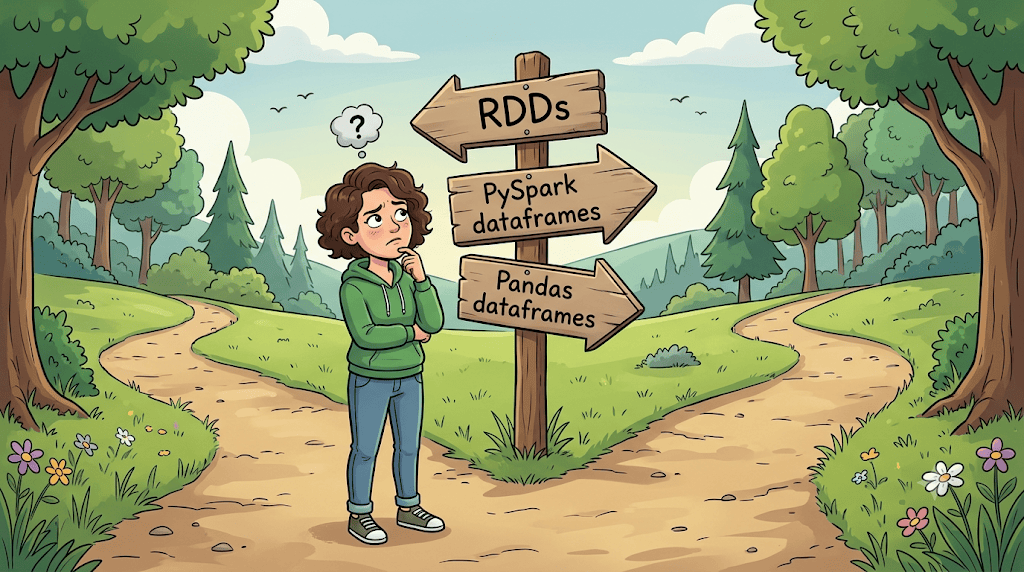
Como os dataframes PySpark são uma abstração dos RDDs, isso significa que ambos realizam processamento em paralelo no cluster. Desta forma, os dados ficam fragmentados pelos diversos nós do cluster, tornando bastante complexa a manipulação dos dados. Uma forma de organizar o processamento dos dados seria dividi-lo em uma fase map, onde o processamento é executado inteiramente apenas no nó principal, e a fase reduce, onde o processamento é executado em paralelo nos diversos nós do cluster. Dividir o processo nestas duas fases quando utilizamos RDDs é algo natural, mas fazer isto com dataframes PySpark exige mais estratégias.
Em uma escala de progressão, os RDDs possuem uma performance extremamente otimizada, porém possuem um altíssimo grau de complexidade para realizar o processamento dos dados. Já os dataframes PySpark são menos otimizados, mas são muito menos complexos para realizar as transformações. Indo mais a frente, temos também a biblioteca Pandas que é bem menos performática que as opções anteriores (o que não quer dizer que não seja bastante performático), porém contém diversas funções que auxiliam no processo de transformação dos dados.
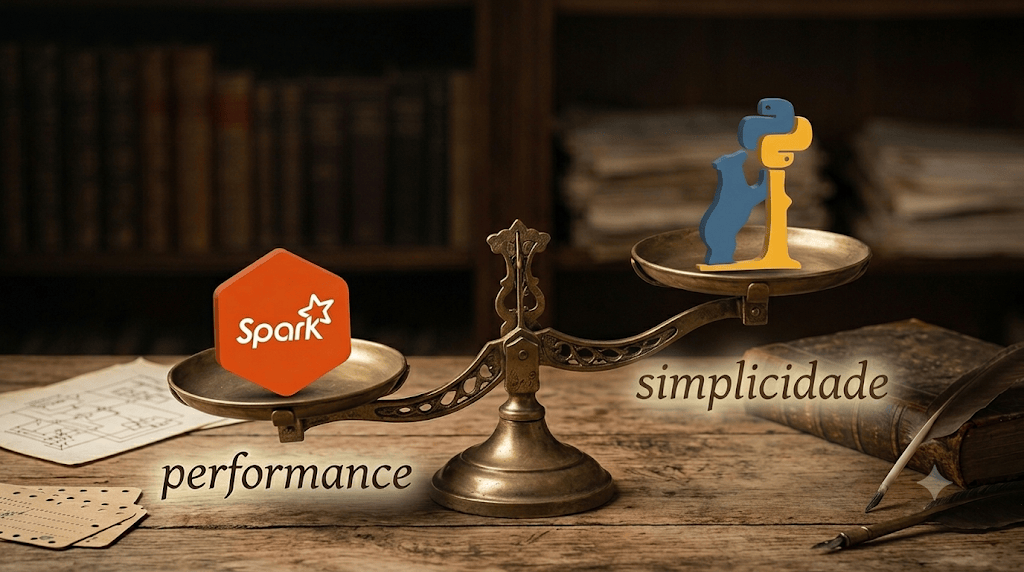
A intercalação entre PySpark dataframe e o dataframe Pandas é tão comum que o PySpark dataframe possui uma função que exporta uma cópia do dataframe no formato Pandas. Contudo, a partir do momento que estamos utilizando a biblioteca Pandas, o dataframe passa a ser processado somente no nó principal. Com isto, quando desenvolvemos em PySpark, estamos sempre em um tradeoff entre a maior performance e maior complexidade do PySpark dataframe e a menor performance e menor complexidade do Pandas. Um exemplo prático deste tradeoff que eu sempre enfrento é a tipagem do schema. O Pandas consegue identificar automaticamente o tipo de cada variável com facilidade. No entanto, quando criamos um dataframe PySpark, é comum que ocorra erros caso não seja especificado todo o schema (tipo de cada coluna). Por vezes, já criei um dataframe em Pandas só para, em seguida, convertê-lo em dataframe PySpark. Só para deixar o Pandas lidar com o schema automaticamente e evitar os erros do dataframe PySpark (calma, eu faço isso só quando estou explorando os dados, não em produção).
Você já teve a oportunidade de utilizar estes dois tipos de dataframe? Qual você achou melhor? Por mais que o dataframe do PySpark seja mais complexo, se você tiver um bom domínio dele pode preferir fazer todas as transformações de dados diretamente nele, assim como eu prefiro escrever scripts Python ao invés de usar planilhas Excel, mesmo para fazer filtros simples. Deixe nos comentários as suas experiências com cada um destes dataframes.
Sources:
https://medium.com/@gankur277/pyspark-dataframe-vs-rdd-choosing-the-right-abstraction-b03c4780d499


Deixe um comentário