
Quando estamos construindo o nosso ambiente de dados analíticos, seja ele um data lake, um data warehouse ou um data lakehouse, percebemos que o negócio realmente utiliza dados de diversas fontes. Para quem já trabalhou em grandes empresas, não é nenhuma surpresa que além das fontes de dados internas é comum haver dados de diversos terceiros e dados públicos também. As formas de aquisição destes dados são as mais variadas possíveis, indo desde dados retornados em forma de JSON por uma API até arquivos transferidos por FTP em formatações específicas criadas ainda nos primórdios da internet. Se eu fosse falar sobre cada forma de aquisição de dados que eu já tive que lidar em minha vida profissional, isto não seria um artigo, seria um livro! Mesmo assim, estou certo de que devo ter explorado apenas 1% das possíveis formas de aquisição de dados.
Por outro lado, acredito que existem algumas formas mais comuns para aquisição dos dados, principalmente quando estamos falando de aplicações com menos de uma década de vida. Na grande maioria das vezes existe uma API que retorna os dados em formato CSV ou JSON. É provável que você já tenha tido esta experiência de extrair dados de uma API, porém, caso você nunca tenha tido esta experiência, você pode treinar um pouco para saber como os dados costumam ser retornados (e principalmente, treinar a modelagem dos dados). Sugiro que você utilize a PokeAPI (https://pokeapi.co/), esta é uma API que retorna informações sobre os pokémons e os diversos jogos em que eles são encontrados. Se você não é um fã de pokémon (eu também não sou), talvez este seja o melhor cenário possível! Afinal, muito provavelmente você também não será fã da maioria dos dados que vai capturar em sua vida profissional.
Para enviar e receber requisições para as APIs, podemos utilizar a biblioteca requests do Python. Esta não é uma biblioteca nativa do Python, sendo necessário adquirí-la por meio do comando pip install. Contudo, o Python possui uma biblioteca nativa do Python para requisições web, a urllib3. Além da biblioteca requests ser muito mais simples de ser utilizada, ela também possui muito mais recursos, por isto acabou por se tornar o padrão para criação de scripts de requisição web. Por tanto, quando adquirimos dados de uma API, utilizamos a biblioteca requests, mas também podemos utilizá-la para capturar páginas web inteiras, contendo todo o código html, css e javascript embutido nelas, isto é o que chamamos de web scraping (ou raspagem de dados). Outro termo comum de ser utilizado é web crawling e a diferença entre os dois é que o web scraping consiste no script capaz de capturar os dados de uma página web, enquanto o web crawling é capaz de identificar links contidos em uma página web e navegar por diversas páginas, adquirindo os seus dados.
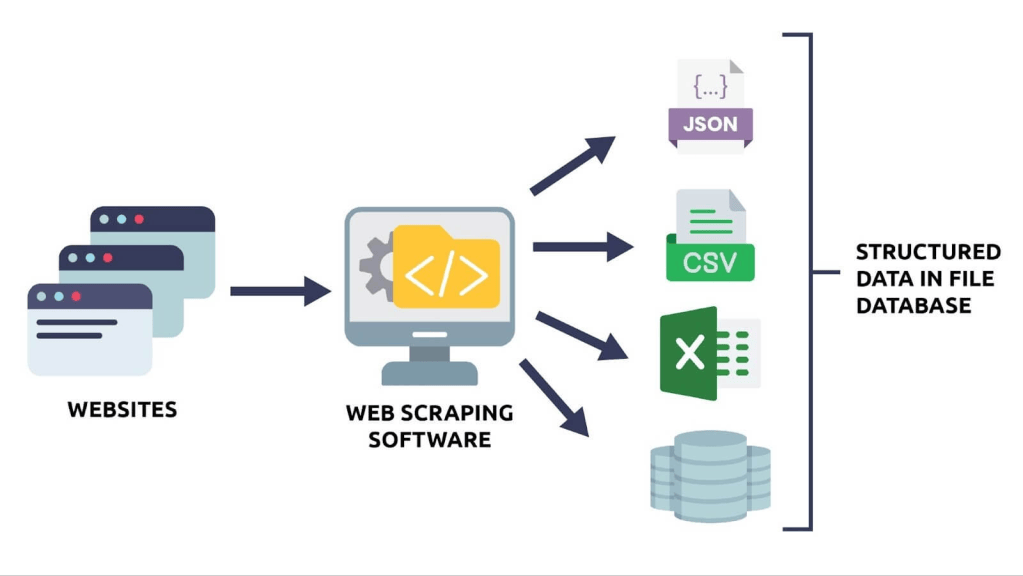
Em meu primeiro trabalho como data engineer eu precisei realizar diversos web scrapes de dados, que consiste em acessar páginas web, extrair o seu conteúdo e navegar pelo código html para conseguir localizar os dados que eu precisava extrair. Isto pode parecer algo trivial, mas definitivamente não é! Nos casos mais simples, conseguimos utilizar a biblioteca BeautifulSoup para conseguir navegar pelo html da página (com sorte ele estará bem organizado e você conseguirá fazer isso sem muito stress), porém há casos onde o código é gerado dinamicamente pelo javascript da página. Nestes casos será necessário utilizar o Selenium, uma biblioteca capaz de simular um web browser, sendo capaz de fazer o código javascript ser executado para assim ser possível acessar os dados desejados. Eu enfrentei problemas como estes para conseguir extrair alguns dados do IBGE, porém, isto foi em 2017. Torço para que as coisas estejam mais fáceis de serem feitas atualmente.
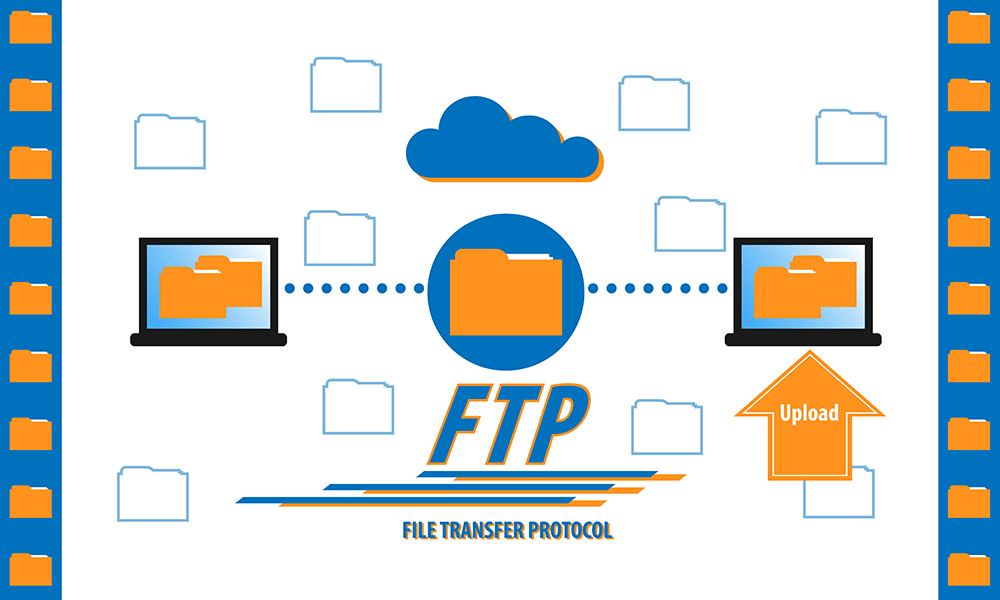
Embora esteja caindo em desuso, ainda há muitas fontes de dados que disponibilizam os dados por meio de um FTP (File Transfer Protocol). Se você nunca ouviu falar de um FTP, não se preocupe, acredito que a humanidade tem tentado esquecer que isso um dia existiu. Não que seja algo ruim, os FTPs muitas vezes facilitam muito a extração dos dados. Contudo, eles se tornaram obsoletos com o surgimento das APIs e com o aumento da velocidade da internet. Isto porque enquanto o HTTP (HyperText Transfer Protocol) foca na transferência de texto, os FTPs focam na transferência de arquivos, sendo muito eficientes para disponibilizar grandes arquivos CSVs contendo os dados desejados. Contudo, os FTPs tem um grande potencial para se tornarem um labirinto de diretórios e arquivos e pouca ou nenhuma documentação. Enquanto isto as APIs geralmente possuem um melhor controle de acesso e documentação padronizada (muitas vezes automatizada), facilitando bastante muito a vida do usuário.
Há também as bibliotecas proprietárias para aquisição dos dados. É comum que grandes fornecedores de dados criem uma biblioteca que executa toda a comunicação com a API padrão, fornecendo funções para que o usuário possa receber os dados desejados. Para a linguagem Python podemos encontrar bibliotecas que fornecem dados sobre as principais redes sociais, como o Facebook, Reddit e Twitter, além de outras plataformas como o Youtube. Podemos também adquirir datasets com bibliotecas como Pandas, o Tensorflow e o próprio Kaggle, além de diversos fornecedores de dados que também fornecem bibliotecas proprietárias.
Para finalizar, é importante também mencionar que há frameworks para web scraping como o Scrapy e iniciativas para criação de bibliotecas que conversam do diversas APIs, como a CCTX que é capaz de se comunicar com diversas APIs de Exchanges de criptomoedos. Eu mesmo já tentei criar uma biblioteca para facilitar a aquisição de dados do NOAA, porém acabei por não seguir em frente por não ter conseguido superar alguns desafios técnicos.
Para um data engineer, a atividade de aquisição de dados é uma constante. Em projetos menores, onde geralmente temos uma atuação mais generalista, isto pode ser também uma atribuição de cientistas ou analistas de dados. Por isso, este é um tema de grande importância para o profissional de dados em geral.

 Cumbuca Dev

Deixe um comentário