
No mundo de dados atual as regras de negócio da empresa podem ser executadas de diversas formas distintas. Em ambientes Big Data utilizando ferramentas como Databricks, MS Data Fabric ou mesmo Spark, é comum ver as regras de negócio serem executadas por scripts em PySpark, Scala ou SQL. Em pipelines menores pode ser que as regras de negócio sejam aplicadas por scripts Python orquestrados por uma instância do Airflow ou ainda por uma instância dbt que implementa as regras de negócio por meio de queries SQL. No entanto, estas tecnologias são relativamente novas e muito antes delas já haviam scripts que implementaram regras de negócios para dados analíticos. A grande maioria destes scripts eram escritos em SQL Procedural Language (SQL PL) que é uma linguagem de programação executada dentro dos bancos de dados.
Este linguagem de programação que utiliza comandos SQL possui todas as estruturas mais comuns nas linguagens de programação, como variáveis, loops e condicionais. O nome da linguagem varia dependendo do banco de dados, seja chamada de PL/SQL no Oracle, T-SQL no SQL Server e PL/pgSQL no Postgres. Os scripts que utilizam esta linguagem de programação quase sempre são criados para implementar regras de negócio que rodam no banco de dados. Contudo, você pode estar pensando que seria muito mais simples utilizar o Pandas para gerar datasets e executar as queries nos próprios datasets. No entanto, quando queremos realizar transações em tabelas com quantidades de dados massivas, estes scripts podem ser uma boa solução por operarem dentro do próprio banco de dados. Além disso, bibliotecas como Pandas são relativamente recentes, então ainda há muitos bancos de dados em funcionamento com as regras de negócio sendo executadas por estes scripts.
Existem três tipos de estrutura implementadas pelo SQL PL, as procedures, as triggers e as functions. Começando pela estrutura mais familiar para quem já possui conhecimento em programação, as functions são funções criadas onde valores são recebidos como inputs, há um processamento interno e ao final um valor é retornado. Funções são criadas para que possam ser utilizadas em queries, em outros scripts ou mesmo em outras funções.
Talvez você tenha pensado “Que ótimo! Vou criar functions que analisem um valor de input e executem um insert em uma tabela caso este valor obedeça algumas condições”. A má notícia é que as functions não executam alterações fora de si mesmas. Isto é, não podem executar comandos como insert, update e delete. A boa notícia é que para estes casos existem as procedures! As procedures (ou stored procedures) são estruturas muito semelhantes as functions, recebendo valores de input para executar processamentos internos. Contudo, as procedures não retornam valor e são capazes de executar comandos que alteram valores em tabelas do banco de dados.
Por fim, temos as triggers. Esta é a estrutura mais comumente utilizada para aplicar regras de negócio, porque ela é capaz de executar um comando SQL de acordo com os valores inseridos em uma tabela. Isso é, quando se cria uma trigger, declara-se uma ação que será executada toda vez que uma nova linha for inserida em uma tabela. Um exemplo simples e muito comum de utilização das triggers são as tabelas que possuem uma coluna chamada updated_at. Isto nada mais é do que uma trigger que insere o horário atual automaticamente para cada linha inserida. As triggers são realmente poderosas, então lembre-se que com grandes poderes, sempre vem grandes responsabilidades! Deve-se ter muito cuidado com a sua utilização abusiva das triggers, pois elas podem gerar um efeito cascata quando um dado inesperado é inserido. Além disso, caso não haja uma boa documentação das regras de negócio, as triggers podem ser esquecidas e ficarem alterando dados por muito tempo, mesmo depois da regra de negócio ter mudado. Causando um estrago enorme no banco de dados.
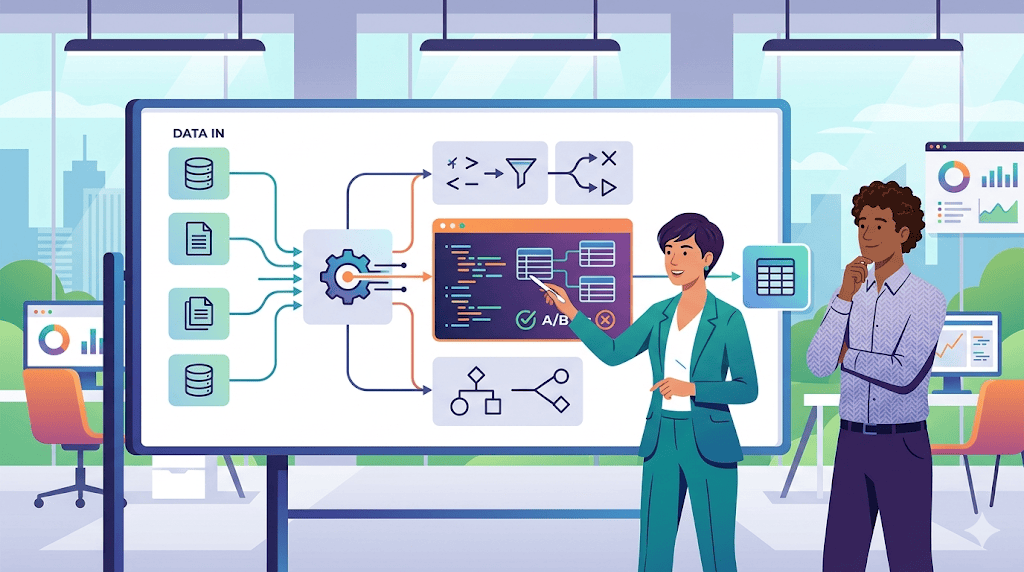
Antes de finalizar, não podemos deixar de citar as views, que embora não sejam construídas com SQL PL, são as estruturas que mais aplicam regras de negócios nas empresas. As views nada mais são do que um alias (apelidos) para uma query que funciona como uma tabela virtual. Isto é, toda vez que uma view é executada, o banco de dados na verdade está executando uma query que estava associada a esta view. É por isto que algumas views podem ser realmente muito lentas, pois o banco de dados está executando uma query toda vez que a view é acessada. Nestes casos, podemos utilizar as views materializadas, onde podemos criar uma view que executará a query em um período de tempo agendado, armazenando o resultado. Assim, o resultado da query não será criado em tempo real, mas sim extraído de uma tabela onde os dados já estavam armazenados.Arrisco dizer que estes scripts SQL PL ainda são os maiores responsáveis por executar regras de negócios dentro das empresas. Embora esteja um pouco ultrapassado, por não se integrar às tecnologias mais modernas de documentação e versionamento de código, ainda é uma forma válida e eficiente de implementar regras de negócio. Você já conhecia a SQL Procedural Language? Deixe um comentário contando a sua experiência com estas estruturas ou, se não as conhecia, o que achou delas.


Deixe um comentário