
Neste artigo vamos falar sobre poesia!
Não, na verdade não vamos, mas vamos falar de uma ferramenta da área de dados que leva o nome do famoso poeta Austro-Hungaro, Franz Kafka. Você deve recordar que no artigo anterior o Kafka foi citado entre as ferramentas que fazem parte do ecossistema Hadoop. Esta ferramenta compartilha algumas características com as demais ferramentas citadas, como o fato de ter sido desenvolvida em Java, ser um projeto open-source e ser mantido pela Apache Foundation. Esta ferramenta consiste em uma aplicação capaz de receber os dados gerados por outras aplicações (ou outras fontes de dados) e distribuí-los entre as demais aplicações existentes dentro da arquitetura da empresa. Além disso, diversos cloud providers criaram serviços que são fortemente inspirados no Kafka, como o AWS Kinesis e o Google Cloud Pub/Sub, enquanto a empresa Confluent oferece o Kafka em si como um serviço 100% gerenciado. Ok, todas essas informações não parecem dizer muita coisa, mas a verdade é que o Kafka é uma das ferramentas mais populares no mundo dos dados atualmente e neste artigo tentarei levantar algumas informações que nos ajudem a entender o motivo por trás desta crescente popularidade.
Pense no seguinte cenário, você acabou de criar uma aplicação simples e ela se conecta diretamente no banco de dados para inserir os dados. Porém, a sua aplicação é um monolito e agora você decide quebrar a aplicação em microsserviços que se comunicam entre si. Ainda é possível manter a comunicação toda sendo realizada por meio de APIs. Porém, agora há também um ambiente separado para analytics, novas fontes de dados externas são inseridas, o número de microsserviços cresce… Uma coisa é certa, em algum momento a comunicação por APIs vai se tornar um pesadelo! É neste momento em que o Kafka pode ser utilizado para trazer melhorias para a arquitetura da empresa.
Uma das principais características do Kafka é que ele é uma solução que pode ser utilizada tanto para fluxos de dados OLTP como para da fluxos de dados OLAP. Isso é, como ele realiza o processo de receber os dados pelas aplicações geradoras e entregar para as aplicações que utilizarão os dados, estas últimas podem ser tanto aplicações que fazem parte da arquitetura transacional como um data lake que irá concentrar dados analíticos. Justamente neste processo de recebimento e entrega dos dados que o Kafka trouxe uma revolução para o mundo dos dados: a arquitetura PUB/SUB. Esta arquitetura consiste na classificação das aplicações como publisher e/ou subscriber. Isto é, no Kafka é possível criar tópicos, sendo estas as estruturas que receberão os dados. Em cada tópico é possível cadastrar aplicações para exercerem a função de publisher, enviando mensagens para o tópico, ou subscriber, lendo as mensagens que são escritas no tópico.
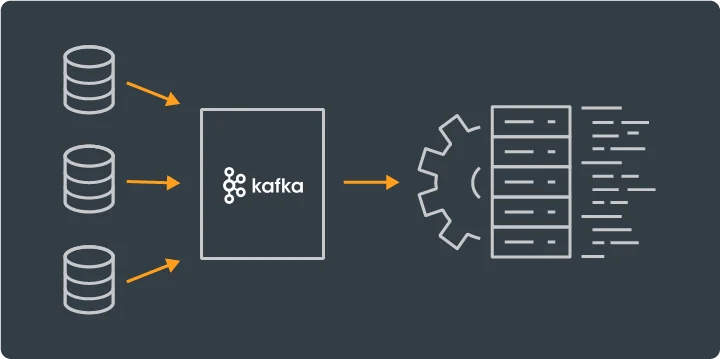
Outra revolução trazida pelo Kafka é o seu processamento em streaming, que é chamado de near real-time (próximo ao tempo real). Se antes as aplicações trafegavam os dados em batch, aglomerando diversas mensagens para não saturar o tráfego de dados, agora o Kafka garante a organização dos dados e realiza o tráfego a nível de evento. Na prática, cada evento ocorrido torna-se uma escrita no tópico que é realizada em formato JSON, com a chave payload contendo os dados enviados pela aplicação. O Kafka também impede que as aplicações sejam sobrecarregadas com mais requisições do que conseguiriam suportar, um problema muito comum em arquitetura de microsserviços que se comunicam por meio de APIs e requisições.
Com todas estas vantagens você pode pensar em aplicar o Kafka em tudo agora, porém, sempre há um outro lado a ser considerado! O Kafka utiliza muito processamento em memória, o que torna ele um serviço muito caro, principalmente se for usado na nuvem. Caso você pense em utilizá-lo como serviço on-premise, logo irá descobrir porque os serviços auto gerenciados do Kafka fazem tanto sucesso. Realizar a sua configuração e manutenção não é fácil, assim como as demais ferramentas que mencionamos no ecossistema Hadoop.
Por fim, espero que tenha gostado de conhecer (se ainda não conhecia) esta ferramenta do mundo de dados. Caso você esteja pensando em seguir a carreira de Engenharia de Dados, eu acredito que esteja entre as ferramentas mais pedidas pelo mercado de trabalho. Se você se interessou em saber um pouco mais sobre esta ferramenta, eu recomendo assistir o tutorial da Apache Foundation (infelizmente só tem em inglês 😢).


Deixe um comentário