
Há uma ferramenta que revolucionou o mundo dos dados, o Spark. Apesar de pouco conhecida, esta ferramenta open-source é a base de inúmeras ferramentas amplamente utilizadas no mundo dos dados. Alguns destes serviços são adaptações simples do Spark desenvolvidas pelos serviços de cloud computing mais populares, como o AWS Glue, AWS Sagemaker, GCP Dataproc, Azure Data Fabric e Azure Data Factory. Contudo, apesar de ser bastante utilizado, poucas pessoas sabem o que exatamente é o Spark e como ele surgiu.
Para entender o que é o Spark, vamos dar muitos passos atrás e entender o cenário da computação no início dos anos 2000. Naquela época o processamento de dados analíticos estava crescendo em volume e complexidade. A solução mais comum era a aquisição de mainframes, que eram computadores superpotentes (geralmente fabricados pela IBM), sendo os únicos capazes de processar grandes volumes de dados.
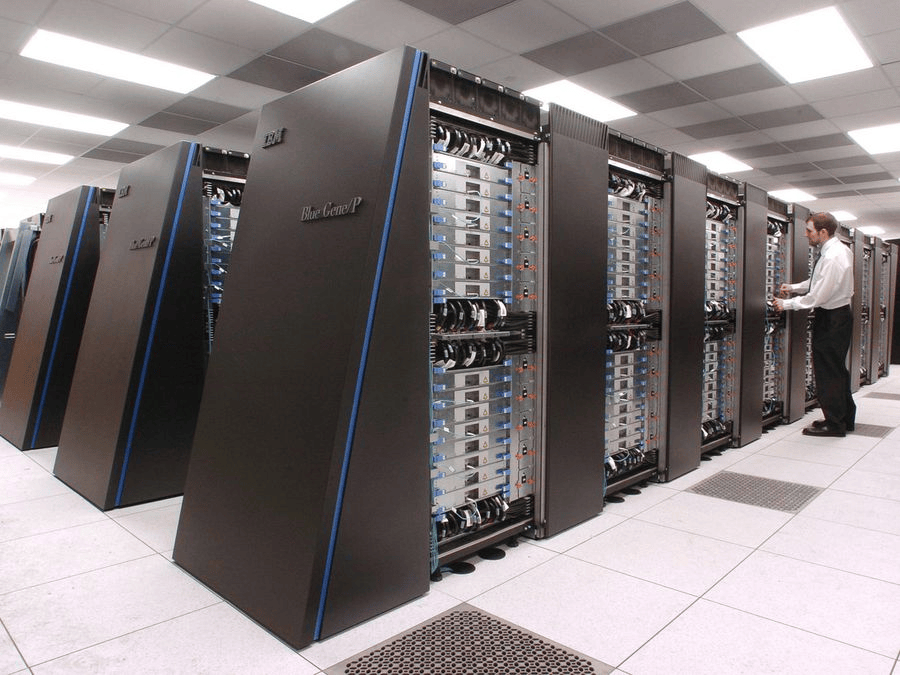
Eu me recordo de uma conversa que tive com um DBA (um dos melhores profissionais com quem já trabalhei), ele me contou que a empresa estava recebendo um mainframe e ele era o responsável por supervisionar a logística de receber, instalar e integrar o mainframe na infraestrutura da empresa. Isso é, dava muito trabalho e custava muito caro!
Com a demanda cada vez maior por capacidade de processamento de dados, muitos profissionais começaram a buscar soluções alternativas aos mainframes, foi então que em 2006 uma equipe do Yahoo criou uma ferramenta chamada Hadoop, sendo basicamente um gerenciador de cluster para processamento de dados em paralelo. Embora a solução fosse revolucionária, ela também era extremamente complexa, possuindo uma arquitetura com diversos componentes que trabalhavam em conjunto para conseguir realizar o processamento dos dados de forma extremamente eficiente. Essa arquitetura utilizava um File Server central chamado HDFS (Hadoop File System) onde era implementado um data lake que era a fonte de dados que seriam processados pelo cluster Hadoop. Em resumo, se antes era necessário comprar um computador superpotente para processar um grande volume de dados, agora era possível conectar diversos computadores (servidores) à um computador central onde o Hadoop faria todo o gerenciamento para que o processamento dos dados fosse distribuído pelo cluster. E assim se iniciou a era do big data!
O Hadoop logo se tornou um projeto open-source e foi incorporado pela Apache Foundation. Com isso, diversas outras ferramentas que eram capazes de se integrar ao Hadoop surgiram. Muitas dessas ferramentas que surgiram nesse momento são extremamente famosas no mundo de dados atual, como o Kafka, o Hive e o Spark. O Spark surgiu como uma otimização do processo MapReduce do Hadoop. Bom, mas o que é MapReduce afinal de contas? Como o processamento é realizado em um cluster, ele pode ocorrer em duas fases, a primeira é a fase map, que ocorre apenas no computador central onde está o Spark (também chamado de nó master). Já a segunda fase é chamada de reduce e ocorre nos outros computadores do cluster. Para dar um exemplo bastante simplificado, se temos uma sequência de números e queremos saber o total da soma de todos os números, precisaremos efetuar o cálculo na fase map, porque na fase reduce cada nó do cluster receberia apenas parte dos número, não sendo possível chegar ao resultado final (lembrando que esse é um exemplo ilustrativo, há questões muito mais complexas caso se queira entender o MapReduce a fundo).
Por fim, enquanto o Hadoop processava os dados em batch, o Spark implementou o processamento em micro-batch e o streaming de dados. Embora ele ainda funcione utilizando os componentes do Hadoop, o Spark se tornou mais conhecido no mundo dos dados. Há alguns anos, os seus criadores se juntaram novamente e criaram uma plataforma que utiliza todas essas tecnologias (e muitas outras criadas posteriormente), sendo este um serviço disponível para ser acoplado aos principais serviços de cloud computing, este é o Databricks.Espero que este artigo tenha sido útil para você.
Eu me recordo de um momento, logo que eu comecei a estudar sobre a área de dados, onde eu e uma amiga conversávamos sobre o Hadoop, mas nenhum de nós dois sabia exatamente qual era a história e o propósito da ferramenta. Caso você esteja nesta situação também, espero que este artigo possa te ajudar a encontrar a saída desse limbo, porque eu demorei bastante para encontrar 😅.


Deixe um comentário