
Ainda seguindo no tema do Processamento de Linguagem Natural (PLN), neste artigo irei falar sobre o tema da minha tese de mestrado: a Análise de Sentimento com classificação em 27 categorias diferentes. O PLN nos possibilita extrair diversos tipos de informações dos textos, sendo uma das aplicações mais conhecidas a Análise de Sentimentos, consistindo na identificação do sentimento geral presente em um texto. Esta técnica geralmente é aplicada para categorizar textos, como comentários de redes sociais ou feedbacks de produtos, em positivo, negativo ou neutro. Isto pode ser muito útil para entender a satisfação geral dos usuários relacionada à um serviço ou produto, contudo, para aplicações onde fosse necessário detectar as nuances dos sentimentos humanos, seria necessário realizar uma categorização mais detalhada. Com este cenário posto, posso dizer que foi exatamente este o tema da minha pesquisa de mestrado, então agora vou compartilhar um pouco as descobertas e as conclusões do meu trabalho.
Quando pensamos em classificar sentimentos, a primeira coisa que nos perguntamos é: quantos sentimentos existem? Se até o filme da Disney precisa fazer retcon para conseguir definir os sentimentos que existem, imagine no meio acadêmico da psicologia. Por isso, eu comecei a pesquisar as classificações de sentimentos mais influentes no meio acadêmico e encontrei uma criada pelo professor pesquisador Paul Ekman. Esta lista me chamou a atenção, pois havia um dataset para treinamento da classificação de sentimentos que se baseia nela, o dataset GoEmotions. Este dataset foi criado a partir da coleta e categorização de mais de 58 mil textos extraídos do Reddit e classificados utilizando as 27 categorias de sentimentos propostas por Paul Ekman. Havia também a possibilidade de não haver nenhum sentimento identificável no texto, sendo classificado como neutro, desta forma totalizando 28 categorias.
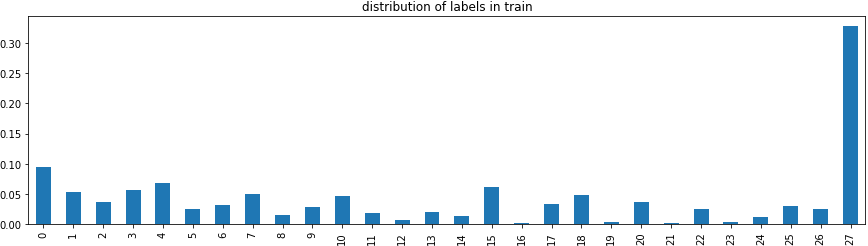
Para realizar o treinamento do modelo foram utilizadas as bibliotecas PyTorch, Transformers, Tez e Scikit Learn para avaliar a performance do modelo. O dataset foi importado utilizando a biblioteca datasets e os dados foram tratados com a ajuda da biblioteca Pandas. Após realizar o processo de tokenização dos labels relacionados às categorias de sentimentos, foi possível analisar a distribuição do total de exemplos por cada categoria. Este passo é importante para verificar se há sub-representação ou super representação de alguma categoria. Fica óbvio que a categoria Neutro está super representada e, com um olhar mais atento, podemos ver que as categorias Pesar (16) e Orgulho (21) estão sub-representadas.
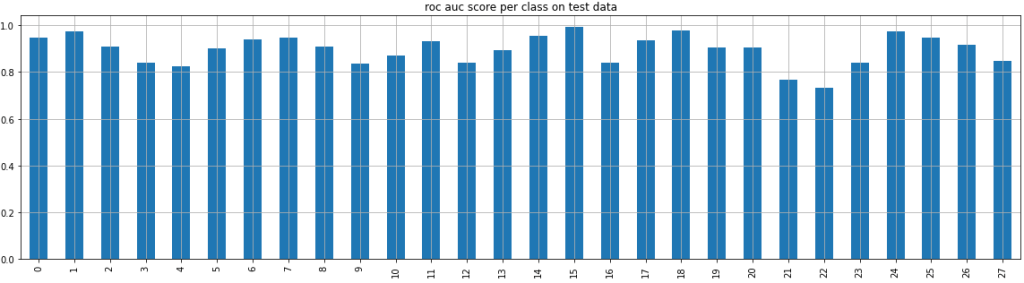
Iniciando agora o treinamento do modelo, foi utilizado o tokenizador SqueezeBertTokenizer para gerar os tokens com base nos textos (apenas lembrando que antes havíamos tokenizado os labels das categorias de sentimento e não os textos em si). Também foi utilizado o optimizador AdamW para realizar o processo de fine-tuning do modelo. Todo o algoritmo para o treinamento do modelo está disponível neste repositório. Ao final do treinamento foi gerado um gráfico ROC AUC para demonstrar a performance de treinamento por categoria.
Agora que possuímos um modelo treinado capaz de classificar os sentimentos presentes em um texto, como podemos utilizar este modelo? No caso da minha pesquisa de mestrado, eu tentei utilizar esta classificação de sentimentos para monitorar as redes sociais e detectar o sentimento relacionado à um grupo de criptomoedas, tentando assim prever possíveis valorizações ou desvalorizações destes ativos. Obviamente, esta é uma das diversas aplicações possíveis, outros exemplos que podemos considerar são: aplicar o modelo em chatbots para entender melhor o usuário ou em pesquisas de audiência para tentar entender as reações do público para um grupo de serviços ou produtos.
Por fim, esta foi uma pesquisa que gostei muito de fazer, porém, infelizmente acabou sendo um pouco ofuscada pelo surgimento das GenAI. Acredito que estas áreas sejam complementares na verdade, pois percebo que a GenAI muitas vezes acabam por seguir em direções conflitantes por não perceber a frustração crescente dos usuários. Eu tive a oportunidade de apresentar este projeto na Python Brasil 2023, então, se você gostaria de saber mais, basta acessar o vídeo da minha palestra.
Referências
de Araújo, R. C. F., Pinto, A. S. R. & Ferrandin, M. (2023). Sentiment Identification on Tweets to Forecast Cryptocurrency’s Volatility. Journal of Computer Science, 19(5), 619-628. https://doi.org/10.3844/jcssp.2023.619.628
Demszky, D. et al. GoEmotions: a dataset of fine-grained emotions. In: Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics. [S.l.: s.n.], 2020. p. 4040–4054.


Deixe um comentário