
Os dados podem ser tratados de duas formas, como transacionais ou como analíticos. Estas visões distintas fazem com que estes precisem ser duplicados. Isto é, dados transacionais e dados analíticos precisam ser fisicamente distintos, isso porque eles precisam ser tratados de formas diferentes e, muitas vezes, incompatíveis. Algumas diferenças entre dados analíticos e dados transacionais:
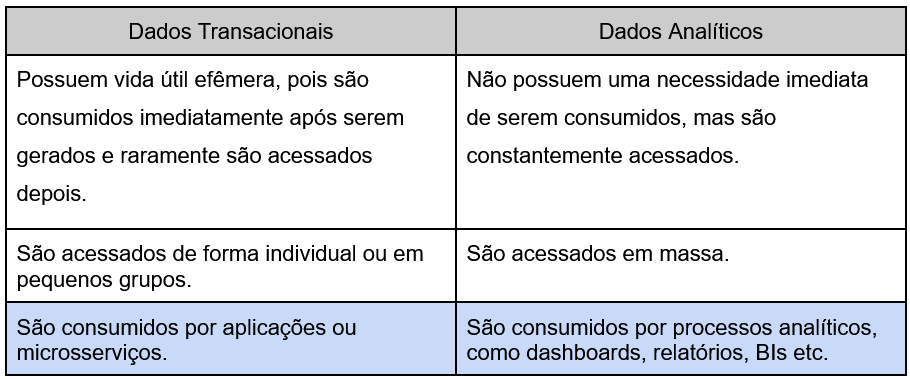
A última regra está em destaque porque é a única realmente absoluta, todas as outras possuem exceções, mas são usadas para definir o comportamento mais comum para os dados. Por exemplo, os dados que descrevem um produto em um e-commerce são acessados constantemente, mas ainda seguem as duas outras regras. Feita esta distinção, hoje falaremos um pouco sobre algumas arquiteturas utilizadas para organizar os dados analíticos.
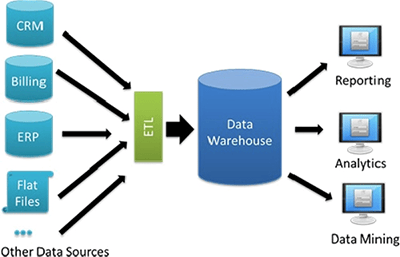
Começando pela arquitetura mais tradicional, o Data Warehouse consiste em uma instância do banco de dados dedicada ao BI e a outros processos analíticos. Nele é feita uma remodelagem dos dados buscando otimizar a performance para a execução de processos analíticos. É comum que os dados de diferentes bancos de dados sejam consolidados nesta instância do Data Warehouse, não sendo necessário onerar os bancos de dados de produção (transacionais) quando forem executados os processos analíticos.
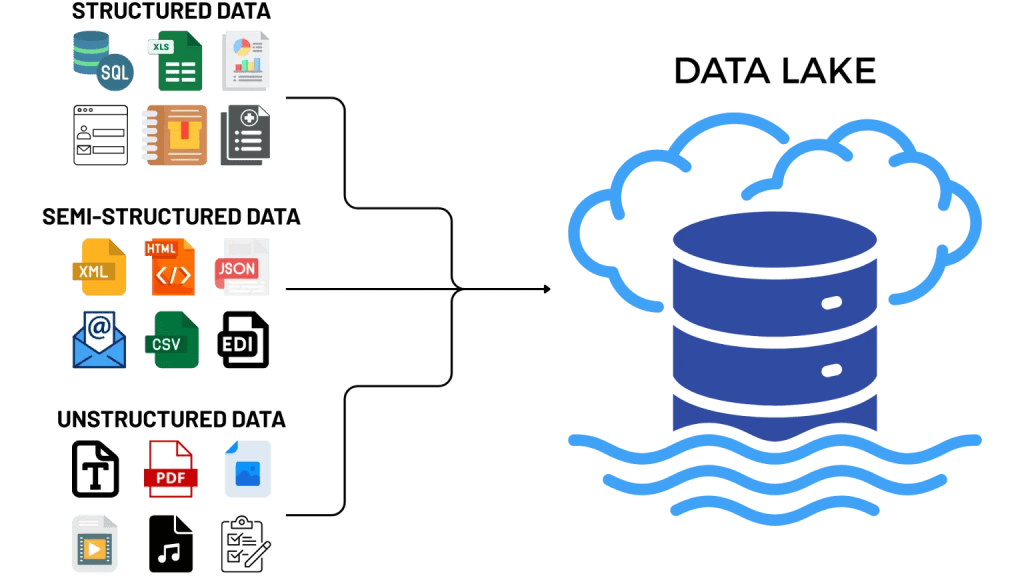
Com o crescimento do volume de dados e a diversificação das estruturas de dados utilizadas surgiu o Data Lake. Eu gosto de pensar no Data Lake como sendo o ambiente Hadoop em si (nunca conheci algum que não fosse). Ele consiste em um file server onde os dados são depositados e processados por um sistema de big data (Hadoop, Spark ou alguma aplicação derivada). Este sistema também é capaz de extrair dados de outros bancos de dados, realizando a junção de dados estruturados, semi-estruturados e não-estruturados. Como um bom dinossauro da área de dados eu já tive a oportunidade de trabalhar em um data lake e sei bem como é fácil ele se tornar um data swamp (pântano de dados).
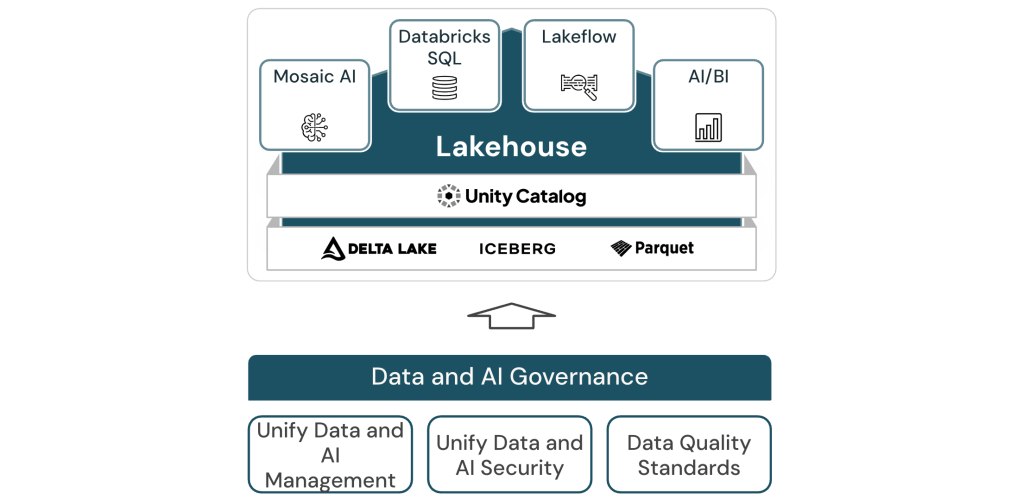
Surgindo para tentar resolver o problema da governança dos dados no data lake, o data lakehouse é uma arquitetura que combina a flexibilidade do data lake com a governança do data warehouse. Criado e popularizado pela Databricks, o data lakehouse utiliza as delta tables para fazer a estruturação dos dados enquanto a aplicação fornece ferramentas que permitem o fácil acesso e governança dos dados. Também é comum que o data lakehouse possua uma arquitetura medalhão, que é uma forma de organizar o processo de transformação dos dados.
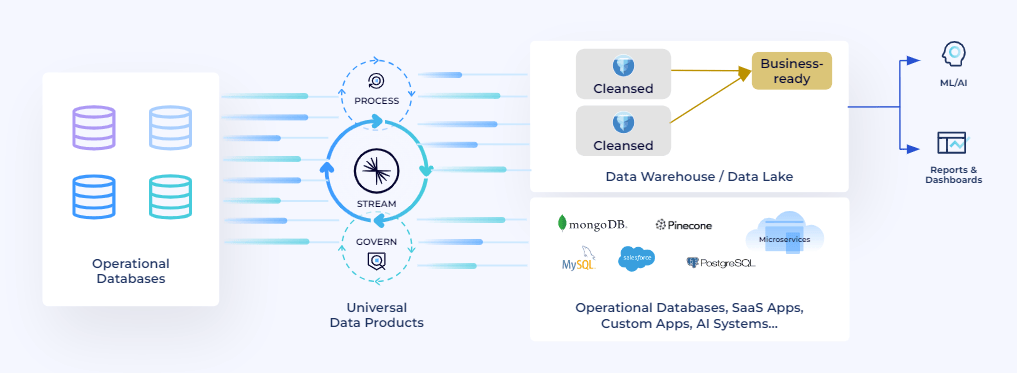
Com a demanda de dados entregues com uma velocidade cada vez maior, alguns processos analíticos estão ganhando características mais próximas dos dados transacionais, por isso a arquitetura Shift Left vem ganhando força nas empresas. Esta arquitetura consiste na mudança de alguns processos analíticos para que sejam feitos com os “dados vivos”. Isso significa que alguns dados de streaming podem sofrer transformações em tempo real e serem entregues ainda no pipeline do processo de streaming. As tecnologias mais utilizadas para realizar este tipo de processo são o Apache Kafka para a execução do pipeline em streaming e o Apache Flink para a realização de transformação dos dados em tempo real.
Existe também o conceito de data warehouse plus onde se realiza todo o processo de um data warehouse, porém utilizando tecnologias que misturam processamentos NoSQL (como bancos de dados colunares) com uma camada SQL para realizar as consultas. Esta é a estrutura mais comum hoje nas startups, porém é comum ver profissionais chamando-as de data lakes. Isto acontece porque os nomes destas arquiteturas são comumente utilizados de maneira freestyle e é comum ver profissionais da área misturando os conceitos. Por isso, espero que este artigo tenha te ajudado a entender a diferença entre cada arquitetura. Esse conhecimento é uma benção e uma maldição ao mesmo tempo, porque agora você sentirá uma dor física toda ver que alguém chamar um banco Postgres de data lake.


Deixe um comentário