
Quando pensamos em machine learning pode ser que para muitos isto envolva sistemas extremamente complexos escritos em uma mistura de linguagem de programação e matemática. Bom, se formos entender a fundo a lógica por trás dos algoritmos de IA, talvez seja realmente bastante complexo (pelo menos para mim, que entendo apenas o básico da matemática).Porém, se quisermos criar um projeto simples de machine learning, isto não requer mais do que algumas poucas linhas de código.
É importante ser honesto e deixar claro que este é um projeto introdutório, totalmente distante do mundo real onde os dados costumam ser muito mais complexos e caóticos. Porém, utilizando a linguagem Python e a biblioteca Scikit Learn, podemos criar um modelo de machine learning capaz de realizar a classificação de três diferentes tipos de flor Íris. Para isto, vamos utilizar um dataset criado por Ronald Fisher que em 1936 realizou a medição das estruturas de diversos exemplares destas flores, classificando-as entre as espécies setosa, versicolor e virginiana. Para treinar um modelo capaz de classificar qual a espécie de cada flor Íris será utilizada a técnica de KNN (K-Nearest Neighbor).
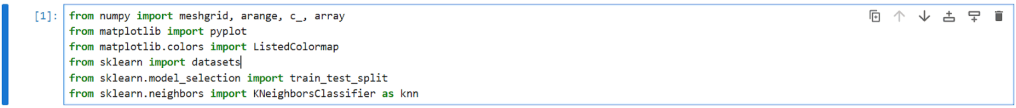
Para este micro projeto, vamos assumir que o leitor já possua uma instalação do Python e um ambiente de desenvolvimento configurado. Vamos utilizar apenas três bibliotecas: Numpy, Matplotlib e SciKit Learn (vamos apresentar o projeto em um Jupyter Notebook, mas a sua instalação é opcional). Após executarmos a instalação das bibliotecas vamos importar algumas funções que usaremos em nosso algoritmo.
Agora devemos realizar o download do dataset Íris e a divisão das medidas da estrutura das flores (X) e da classificação da espécie de cada flor (Y). Além disso, vamos separar 80% do dataset para realizar o treino e 20% para realizar o teste do modelo. Utilizando o parâmetro test_size na função train_test_split, podemos inserir um valor de 0.0 à 1.0 para indicar a porcentagem do dataset que será dedicada ao teste, finalizando a divisão no nosso dataset em quatro variáveis. A partir do momento que o dataset é lido e está em memória passamos a chamá-lo de dataframe.

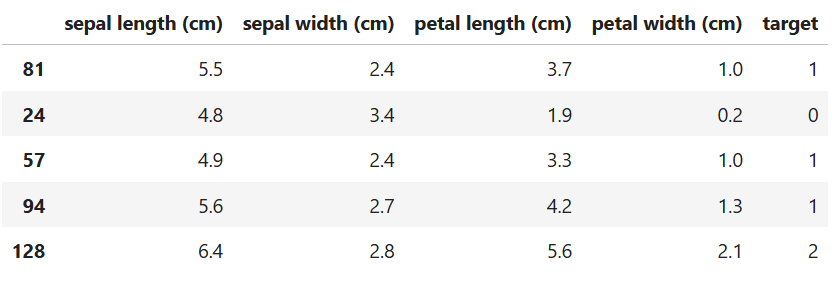
Podemos visualizar os valores no dataframe original a seguir.
Agora vamos realizar o treinamento do nosso modelo.
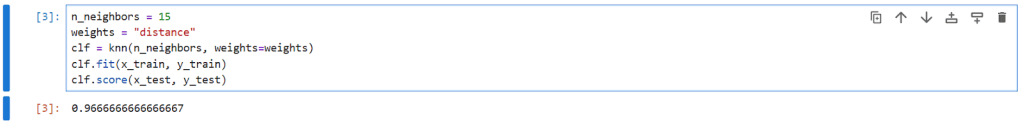
Sim, apenas com estas poucas linhas de código nós já possuímos um modelo de machine learning treinado. Utilizando a função score podemos verificar a acurácia média do modelo que foi de 96% (vou falar sobre isto na conclusão do artigo).
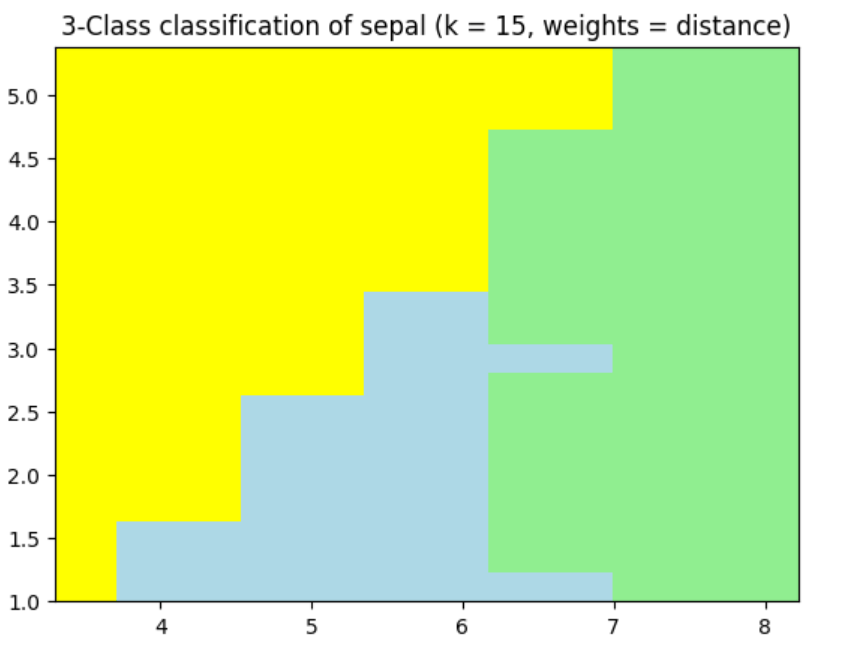
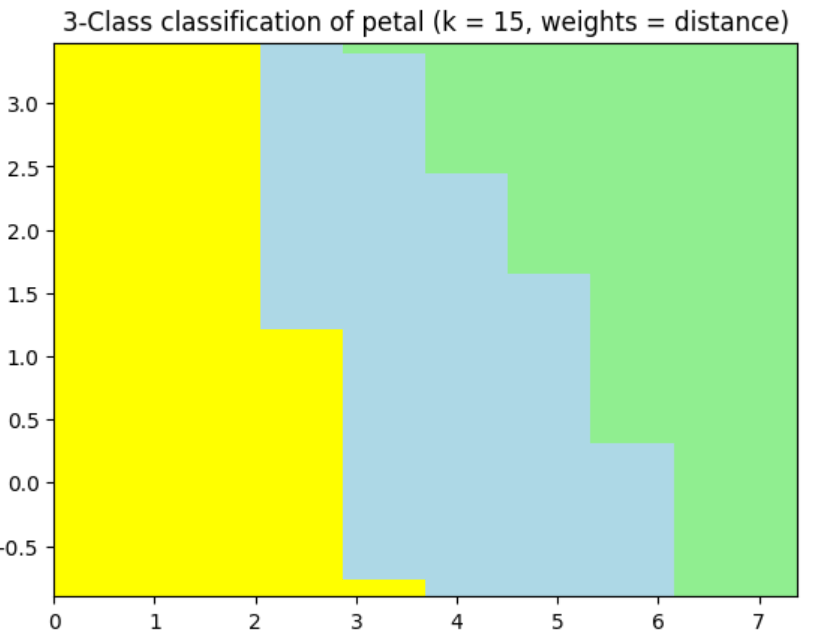
Para entendermos um pouco mais sobre o dataframe com o qual nós estamos trabalhando, podemos gerar dois gráficos. No primeiro é mostrada a divisão dos de cada tipo de flor pelo tamanho da sépala, no segundo é mostrada a divisão pelo tamanho da pétala.
Este artigo foi pensado com dois objetivos principais. O primeiro era demonstrar que algumas técnicas de machine learning são simples e podem ser executadas com poucas linhas de código. A segunda era demonstrar que, em alguns raros casos, um simples modelo de machine learning é o suficiente para criarmos um modelo extremamente eficiente. Este modelo possui 96% de acurácia média e parece ser uma solução mais que suficiente para identificar este tipo de flor. Obviamente que existem outras questões a serem verificadas, como a dificuldade de se ter um dataset organizado como este no mundo real e a possibilidade do modelo estar viciado. Porém, o ponto é que, às vezes, uma técnica simples de IA é mais que o suficiente para criar uma solução eficiente. Então, por que não começarmos pelo simples?
Para escrever este artigo eu me baseei na minha própria palestra realizada para o PET Matemática da UFSC e o código utilizado está disponível no meu Github.


Deixe um comentário