
Neste artigo irei dar uma introdução à alguns conceitos básicos de inteligência artificial e explorar algumas técnicas de machine learning. Se você já possui algum conhecimento na área, eu recomendo que continue lendo o artigo mesmo assim, afinal é um artigo curto e eu sempre gosto de fazer alguns comentários relacionados as minhas experiências profissionais.
O machine learning consiste em um grupo de técnicas de inteligência artificial como a regressão linear, support vector machine (SVM), K-Nearest Neighbor (KNN), deep learning etc. Estas técnicas são divididas em dois grupos: Aprendizado supervisionado e aprendizado não-supervisionado. É importante saber que todas estas são técnicas de machine learning para entender que cada uma delas possui uma melhor aplicação em um contexto específico.
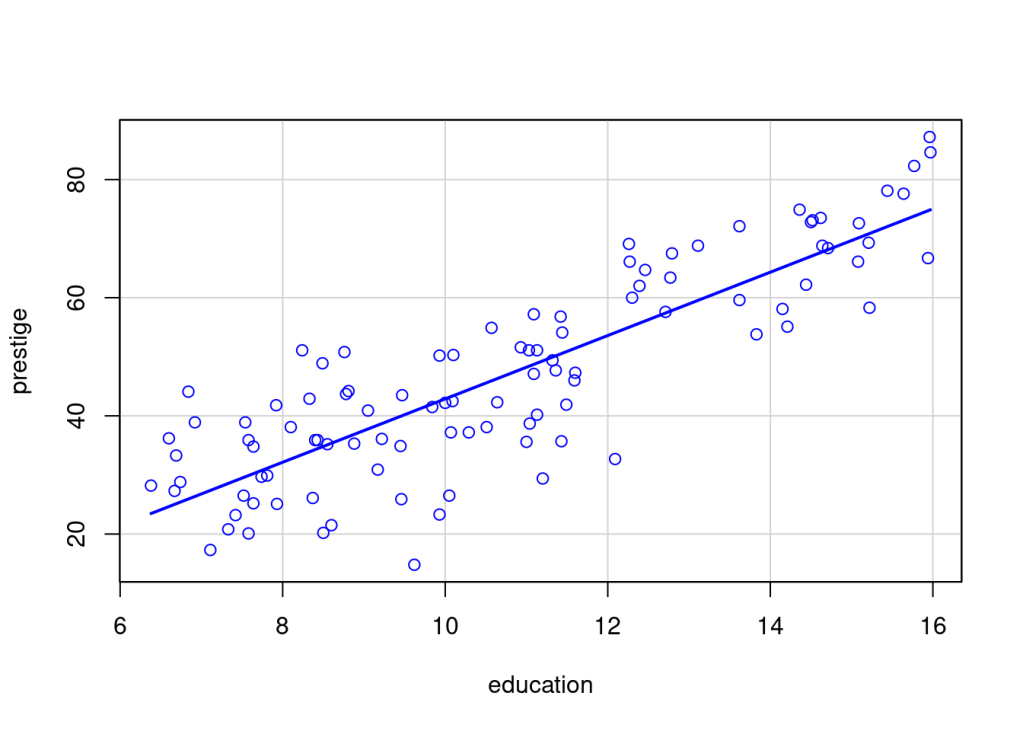
Começando pela regressão linear, esta é uma técnica matemática básica que consiste em encontrar um padrão definido pela média de valores nos eixos (podendo haver dois ou mais eixos) para realizar uma predição sobre valores ausentes em novos inputs para um ou mais eixos. Esta definição parece muito complexa (e é, porque eu decidi escrever da minha cabeça ao invés de copiar de algum lugar), mas a imagem abaixo simplifica tudo. Para um novo input do eixo x, o valor previsto para y será aquele encontrado na linha traçada. Obviamente, por precisar de um histórico de dados para traçar uma linha preditiva, esta é uma técnica de treinamento supervisionado.
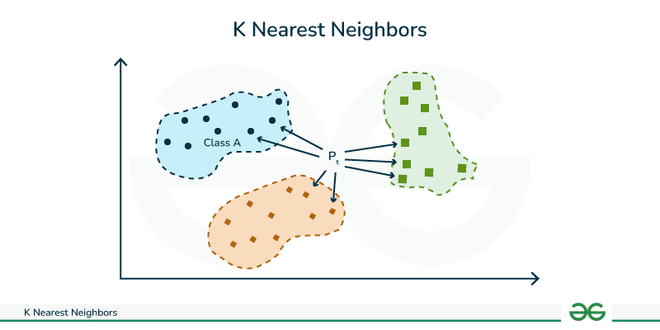
Falando agora sobre o KNN, este se trata de um algoritmo de classificação onde os valores são agrupados de acordo com a sua proximidade. Este também se trata de um algoritmo de aprendizado supervisionado, bastando informar o número de grupos que devem ser criados durante o processo de classificação (valor de K) e fornecer um dataset com os grupos a que cada elemento pertence. Com isto o algoritmo irá classificar os novos inputs de acordo com a proximidade dos grupos já formados.
Por fim, vamos falar sobre o deep learning. Esta é uma técnica bastante complexa que envolve uma arquitetura baseada na ideia (antiga) de como o nosso cérebro funciona. Basicamente o deep learning consiste em testar diferentes combinações de pesos para as features (dados inseridos) buscando a melhor combinação possível para chegar até a resposta desejada. Existem diversos algoritmos de deep learning, mas o mais famoso entre eles é o Tensorflow. Existem também diversas técnicas para aplicação de deep learning e cada uma delas costuma ser mais eficiente com para criar modelos preditivos para um tipo específico de problema, como o CNN para imagens, RNN para textos e até mesmo PINNs para problemas que envolvem cálculos diferenciais.
Assim como a maioria das tecnologias, cada técnica de machine learning funciona bem para um contexto específico. Talvez esta seja uma das áreas onde a expressão “usar um canhão para matar uma mosca” mais se aplica. É comum ver empresas querendo utilizar técnicas avançadas de deep learning para problemas que seriam facilmente resolvidos com uma simples regressão linear. Eu mesmo já tive a experiência de entrar em um projeto de NLP onde foram discutidas diversas técnicas de machine learning para serem aplicadas e, no fim, eu consegui atingir 98% de assertividade com um simples algoritmo utilizando REGEX.
Por isso, é importante aprender a lógica por trás de cada técnica de machine learning. Devemos sempre optar pela solução que seja mais eficiente e mais simples, abrindo mão da simplicidade apenas quando em troca obtemos um aumento significativo na efetividade.

 Cumbuca Dev

Deixe um comentário